بررسی کد تولیدشده با هوش مصنوعی؛ از نیاز تا تست مرزی
با یک مثال کوچک پایتون یاد بگیرید نیاز را دقیق بنویسید، جواب درست را مستقل تعیین کنید، تست مرزی بسازید و تفاوت اجرای موفق با رفتار درست را تشخیص دهید.
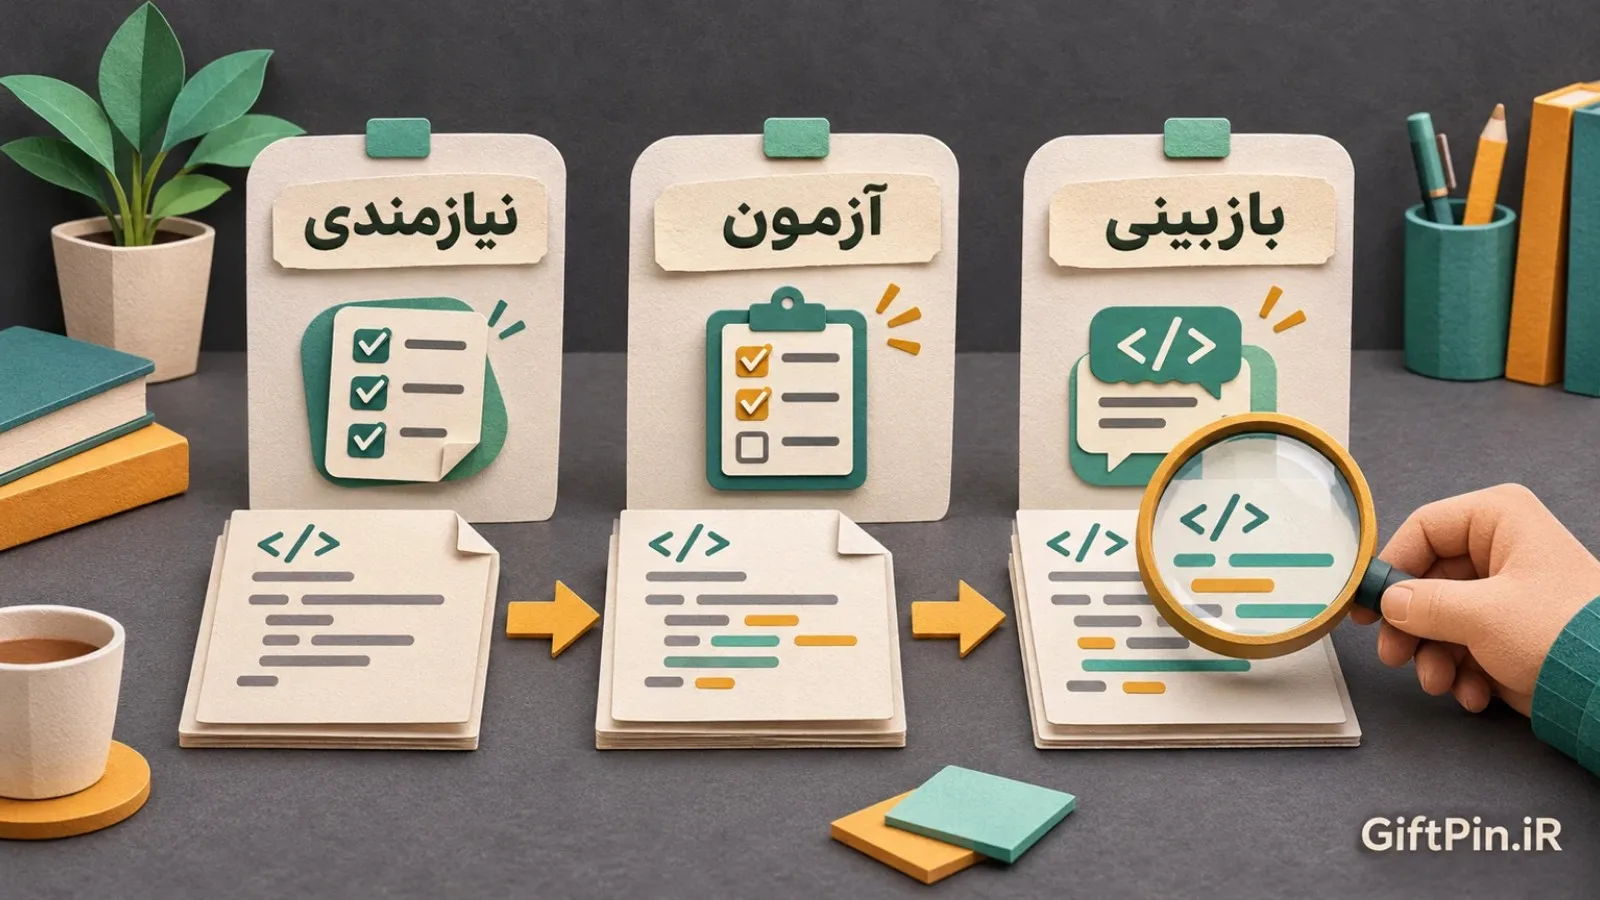
برای بررسی کد تولیدشده با هوش مصنوعی، از سؤال «آیا اجرا میشود؟» شروع نکنید. ابتدا مشخص کنید کد باید چه رفتاری داشته باشد، سپس خروجیهای موردانتظار را مستقل از پیادهسازی بنویسید، تغییرات را بخوانید و آزمونهایی اجرا کنید که امکان آشکارکردن اشتباه را دارند. کدی که بدون خطا اجرا میشود یا چند تست سبز دارد، لزوماً نیاز شما را درست پیاده نکرده است.
این راهنما با یک مثال کوچک پایتون، روش فکرکردن درباره بازبینی را آموزش میدهد. مثال، تعرفه یا سرویس واقعی نیست و به داده مشتری، شبکه، پرداخت یا نصب بسته نیاز ندارد. هدف، یادگیری تصمیمهای قابلآزمون است؛ نه آموزش مسیر دکمههای Cursor و نه وعده تولید نرمافزار بدون باگ.
اول قرارداد رفتاری، بعد تولید کد
درخواست «یک تابع هزینه ارسال بنویس» مبهم است. عامل نمیداند واحد وزن چیست، مرز بسته سبک کجاست، وزن صفر معتبر است یا نه و ورودی اشتباه باید چه نتیجهای داشته باشد. اگر این تصمیمها را به مدل واگذار کنید، ممکن است کد از نظر نحوی درست باشد اما قانون دلخواه شما را اجرا نکند. قبل از نوشتن، تعریف مسئله را به چند گزاره روشن تبدیل کنید.
برای مثال آموزشی ما، قرارداد چنین است: وزن فقط عدد صحیح بر حسب گرم و بین ۱ تا ۵۰۰۰ است؛ تا وزن ۱۰۰۰ گرم، هزینه پایه ۴۰ واحد فرضی و از ۱۰۰۱ تا ۵۰۰۰ گرم، ۷۰ واحد فرضی است. مقصد دور فقط با مقدار بولی مشخص میشود و ۱۵ واحد اضافه دارد. وزن خارج از محدوده باید ValueError و نوع نامعتبر باید TypeError ایجاد کند. هیچ تبدیل خودکار رشته یا عدد اعشاری انجام نمیشود.
این اعداد صرفاً برای تمریناند. در پروژه واقعی، مقررات را صاحب محصول تعیین میکند و تغییرشان نیازمند تصمیم مشخص است. همچنین انتخاب نوع خطا بخشی از قرارداد این مثال است؛ در یک رابط وب شاید خطا به پیام قابلفهم برای کاربر تبدیل شود، اما آن لایه در دامنه این تابع نیست.
از مدل چه بخواهیم که خروجی قابل بررسی باشد؟
یک درخواست مناسب میتواند این باشد: «فقط تابع محاسبه و تستهای آن را مطابق قرارداد زیر بنویس. بسته جدید، ارتباط شبکه، فایلخوانی یا تغییر بخشهای نامرتبط اضافه نکن. ابهام را پیش از پیادهسازی مشخص کن. در پایان فایلهای تغییرکرده، آزمونهای اجراشده و چیزهای آزمودهنشده را جدا گزارش کن.» سپس قرارداد دقیق را اضافه کنید.
راهنمای رسمی Best practices for coding with agents از Cursor، برنامهریزی پیش از کار و ارائه زمینه مناسب را مطرح میکند. برداشت کاربردی برای این مثال، طرح طولانی نیست؛ همان چند تصمیم ورودی و خروجی کافی است. اگر مدل برای چنین تابعی سراغ تغییر ساختار کل برنامه رفت، دامنه کار را دوباره روشن کنید. بزرگترشدن تغییر الزاماً نشانه بهترشدن راهحل نیست.
جواب درست را پیش از دیدن کد تعیین کنید
جدول زیر را از قرارداد میسازیم، نه از پاسخ تابع. این تفاوت مهم است: اگر «پاسخ موردانتظار» را از همان کدی بگیریم که در حال آزمون آن هستیم، ممکن است اشتباه کد را بهعنوان معیار صحت وارد تست کنیم. نزدیک مرزها، یک واحد اختلاف میتواند شاخه محاسبه را عوض کند؛ بنابراین عددهای دقیق مرزی مهمتر از چند ورودی تصادفیاند.
ورودی وزن | مقصد دور | انتظار | علت انتخاب |
|---|---|---|---|
۱ | False | ۴۰ | کمترین وزن مجاز |
۹۹۹ | False | ۴۰ | پیش از مرز هزینه |
۱۰۰۰ | False | ۴۰ | خود مرز در شاخه سبک |
۱۰۰۱ | False | ۷۰ | بلافاصله پس از مرز |
۵۰۰۰ | False | ۷۰ | بیشترین وزن مجاز |
۱۰۰۰ | True | ۵۵ | افزایش هزینه مقصد دور |
۱۰۰۱ | True | ۸۵ | مقصد دور در شاخه دوم |
۰، منفی یا ۵۰۰۱ | False | ValueError | خارج از محدوده |
رشته، اعشاری، None یا bool | False | TypeError | نوع وزن نامعتبر |
یک پیادهسازی کوچک و قابل توضیح
کد زیر مطابق قرارداد آموزشی نوشته شده است. خواننده باید بتواند هر شرط را به یکی از قواعد بالا وصل کند. اگر یک خط را نمیتوانید به نیاز مشخصی نسبت بدهید، از نویسنده یا عامل دلیلش را بخواهید؛ توضیح مبهمی مثل «برای حرفهایترشدن» کافی نیست.
def shipping_cost(weight_g, remote=False):
    if isinstance(weight_g, bool) or not isinstance(weight_g, int):
        raise TypeError('weight_g must be an integer')
    if not isinstance(remote, bool):
        raise TypeError('remote must be a boolean')
    if not 1 <= weight_g <= 5000:
        raise ValueError('weight_g must be between 1 and 5000')
    base = 40 if weight_g <= 1000 else 70
    return base + (15 if remote else 0)
چرا bool جدا بررسی شده است؟ مستند انواع داخلی Python توضیح میدهد bool زیرنوع int است. بنابراین بررسی ساده isinstance(value, int) میتواند True را هم بپذیرد، در حالی که در قرارداد ما مقدار منطقی، وزن نیست. مستند توابع داخلی نیز میگوید isinstance زیرنوعها را در نظر میگیرد. این نمونه نشان میدهد شناخت زبان بخشی از بازبینی است، نه صرفاً سلیقه در نامگذاری.
همچنین 1000.0 با وجود ظاهر عددی، در این قرارداد پذیرفته نمیشود. اگر پروژه واقعی شما اعشار میخواهد، باید قرارداد، دقت و واحد را تغییر دهید و تست تازه بنویسید؛ حذف کنترل نوع صرفاً برای سبزشدن تست، اصلاح درست مسئله نیست. در این مثال همه مقدارهای محاسبه صحیحاند تا تمرکز روی مرزها و اعتبارسنجی بماند.
تست مستقل چه شکلی دارد؟
نمونه زیر از کتابخانه استاندارد unittest استفاده میکند. آن را در کنار تابع بالا در یک فایل آموزشی در نظر بگیرید؛ نصب وابستگی لازم ندارد. مطابق مستند رسمی unittest، assertEqual برای مقایسه نتیجه، assertRaises برای انتظار خطا و subTest برای تفکیک حالتهای یک آزمون به کار میروند. مقدارهای expected از جدول قرارداد آمدهاند.
import unittest

class ShippingTests(unittest.TestCase):
    def test_valid_cases(self):
        cases = [(1, False, 40), (999, False, 40),
                 (1000, False, 40), (1001, False, 70),
                 (5000, False, 70), (1000, True, 55),
                 (1001, True, 85)]
        for weight, remote, expected in cases:
            with self.subTest(weight=weight, remote=remote):
                self.assertEqual(shipping_cost(weight, remote), expected)

    def test_invalid_weight_range(self):
        for weight in (-1, 0, 5001):
            with self.subTest(weight=weight):
                with self.assertRaises(ValueError):
                    shipping_cost(weight)

    def test_invalid_weight_type(self):
        for weight in (True, False, 1000.0, '1000', None):
            with self.subTest(weight=weight):
                with self.assertRaises(TypeError):
                    shipping_cost(weight)

    def test_invalid_remote_type(self):
        for remote in (0, 1, 'yes', None):
            with self.subTest(remote=remote):
                with self.assertRaises(TypeError):
                    shipping_cost(1000, remote)

if __name__ == '__main__':
    unittest.main()
نکته شمارش: این کلاس چهار متد تست دارد، اما داخل آنها چندین ورودی مستقل بررسی میشود. پس اگر گزارش اجرا «۴ تست» نشان داد، به معنی تنها چهار ردیف داده نیست. برعکس، تعداد زیاد ردیفها هم بهتنهایی کیفیت را ثابت نمیکند؛ باید ببینید هرکدام کدام رفتار را بررسی میکنند.
از کجا بفهمیم تست واقعاً میتواند اشتباه را بگیرد؟
یک تمرین مفید، بررسی یک تغییر عمدی و محدود در نسخه آموزشی جداست. فرض کنید شرط وزن سبک از weight_g <= 1000 به weight_g < 1000 تبدیل شود. طبق قرارداد، ورودی ۱۰۰۰ همچنان باید ۴۰ بدهد؛ نسخه اشتباه ۷۰ میدهد. اگر تست مرزی شما با این تغییر هم سبز بماند، احتمالاً آن رفتار را واقعاً نمیسنجد یا نسخه دیگری از کد اجرا میشود.
این تمرین مجوز دستکاری برنامه اصلی یا ایجاد خطا در محیط مشتری نیست. هدف، سنجیدن قدرت تست روی نمونه جداگانه است. پس از تمرین نیز نسخه نادرست نباید بهعنوان راهحل نگه داشته شود. در پروژههای واقعی، آزمون تغییر عمدی باید در محیط و فرایند موردتأیید تیم انجام شود.
تست کاذب همیشه پیچیده نیست. عبارت assertEqual(shipping_cost(1000), shipping_cost(1000)) فقط دو بار یک پاسخ را مقایسه میکند؛ نمیگوید آن پاسخ درست است. تستی که فقط «نتیجه عدد است» را بررسی کند هم ممکن است هزینه نادرست را نبیند. یک خطای رایج دیگر این است که بعد از شکست تست، expected را به عدد خروجی تغییر دهیم بیآنکه قرارداد عوض شده باشد.
بازبینی diff: چه چیزهایی تغییر کردهاند؟
Diff نمایش تفاوت نسخه قبل و بعد است. آن را فقط برای پیدا کردن غلط تایپی نخوانید. ابتدا فهرست فایلها را ببینید: آیا تغییرها در محدوده تابع و تستها هستند؟ سپس رفتار را بررسی کنید: آیا قرارداد قبلی جایی شکسته شده، خطاها پنهان شدهاند یا منطق مشابه دوباره نوشته شده است؟ اگر تغییر نامرتبطی وجود دارد، پیش از پذیرش دلیلش را روشن کنید.
راهنمای بررسی و آزمون Cursor تأکید میکند معیار پذیرش کد عامل نباید از کد انسانی پایینتر باشد و تغییرهای کوچک و منطقی بازبینی را آسانتر میکنند. برای مثال حاضر، بازنویسی تنظیمات پروژه یا افزودن یک کتابخانه محاسباتی جدید نیاز مشخصی ندارد. اگر چنین تغییری پیشنهاد شده، همان تابع کوتاه را جدا بررسی کنید و دامنه را بیدلیل بزرگ نکنید.
هنگام خواندن تستها هم مراقب حذف باشید. ممکن است تست جدید اضافه شده باشد اما یک تست قدیمی دشوار کنار گذاشته شده باشد. از عامل بخواهید تستهای حذفشده یا ضعیفشده را جدا نام ببرد. سبزشدن مجموعهای کوچکتر، بهتنهایی نشاندهنده بهترشدن برنامه نیست.
بازبینی خودکار کمک است، نه رأی نهایی
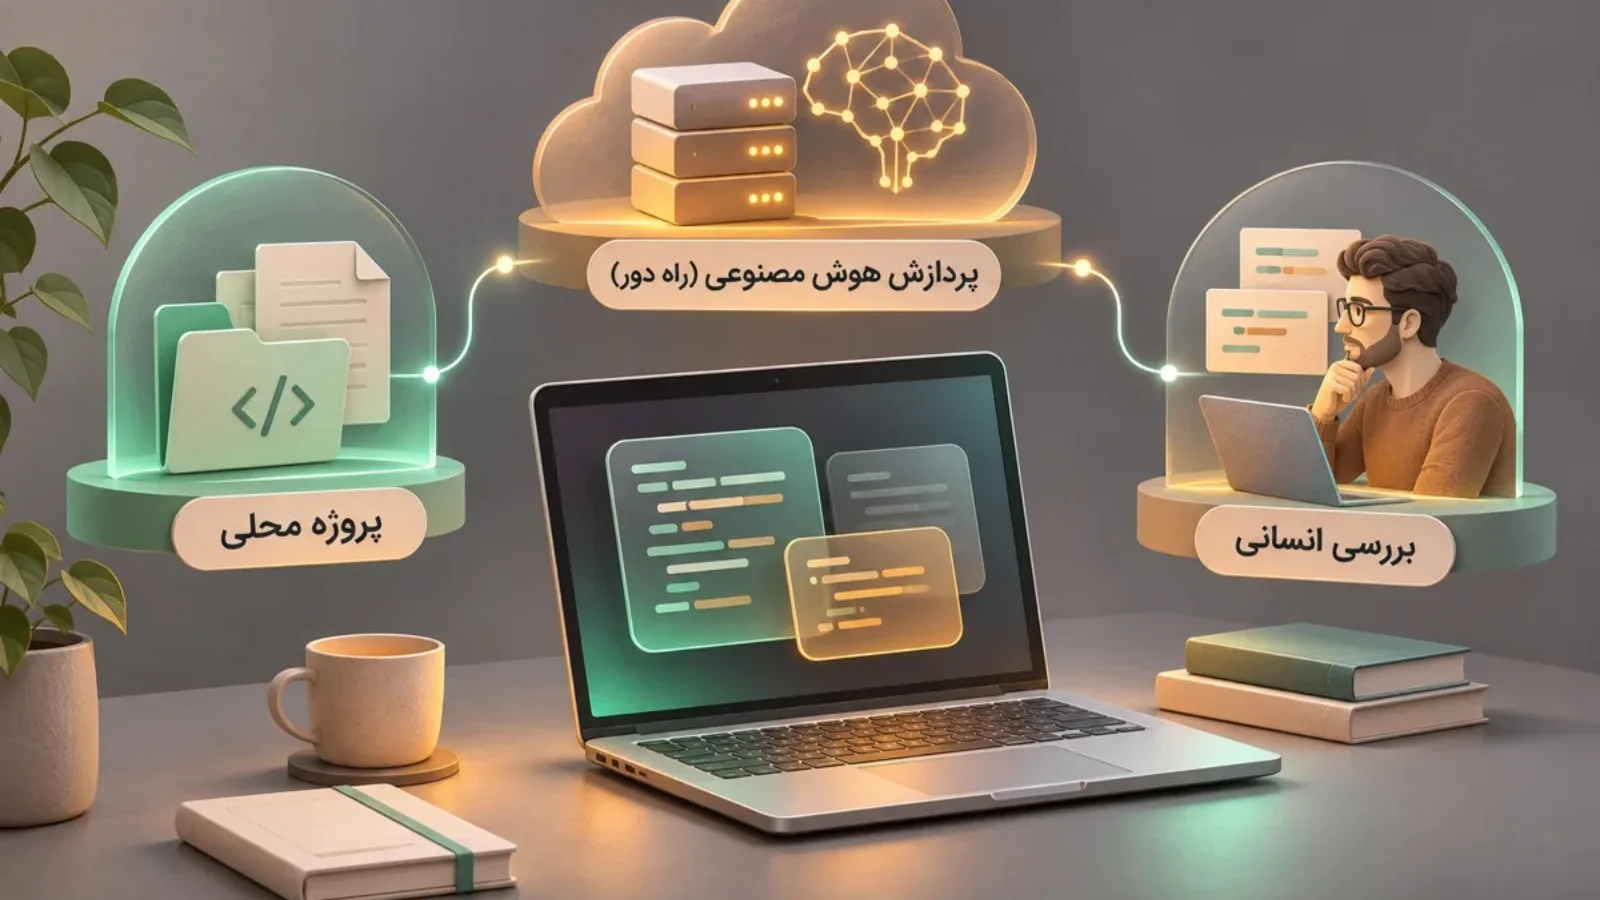
مستند Agent Review در Cursor یک قابلیت بازبینی اختصاصی برای تغییرهای محلی و سطحهای بررسی متفاوت را شرح میدهد. این مقاله مسیر تنظیمات آن را آموزش نمیدهد، چون رابط و دسترسی نسخهها ممکن است فرق کند. نکته مهم برای تصمیم شما این است که گزارش ابزار را به ادعاهای قابلآزمون تبدیل کنید: مشکل کجاست، با چه ورودی رخ میدهد و اصلاح چگونه سنجیده میشود؟
اگر عامل اول کد و عامل دوم تست را نوشته باشد، استقلال کامل حاصل نشده است؛ ممکن است هر دو یک برداشت مبهم از نیاز را تکرار کنند. معیار مشترک باید قرارداد روشن باشد. یک بازبین انسانی که قانون وزن ۱۰۰۰ را میداند، میتواند تناقض را ببیند حتی اگر توضیح مدل بسیار مطمئن باشد.
چه چیزی هنوز با این تستها ثابت نشده است؟
تابع ما یک واحد کوچک و بدون ورودی و خروجی بیرونی است. آزمون آن نشان نمیدهد فرم وب وزن را درست دریافت میکند، پیام خطا درست نمایش داده میشود یا سرویس دیگر واحد گرم را با کیلوگرم اشتباه نمیگیرد. اینها به آزمون ارتباط اجزا نیاز دارند. اگر در برنامه مقدار ۱٫۲ کیلوگرم وارد میشود، تبدیل آن به ۱۲۰۰ گرم باید قرارداد و تست جدا داشته باشد.
همچنین این مثال درباره همزمانی، دسترسی کاربران، قطع شبکه یا عملکرد زیر بار چیزی را اثبات نمیکند. این محدودیت عیب آموزشی نیست؛ دامنه دقیق، از ادعای بیش از شواهد جلوگیری میکند. گزارش خوب میگوید «رفتارهای جدول این تابع بررسی شد»، نه «کل سامانه کاملاً امن و بدون باگ است».
گزارش تحویل که بتوان به آن اعتماد کرد
نیاز: تابع دقیقاً کدام قرارداد را پیاده میکند؟
دامنه: کدام فایلها و رفتارها تغییر کردهاند و کدام بخشها عمداً دستنخوردهاند؟
آزمون: چه مجموعهای، روی کدام نسخه و با چه نتیجهای اجرا شده است؟
مرزها: ورودیهای صفر، سقف، اطراف مرز و نوع نامعتبر چه نتیجهای دارند؟
ابهامها: چه تصمیمی هنوز به صاحب محصول وابسته است؟
محدودیت: چه چیزی آزموده نشده و مرحله بعدی بررسی چیست؟
میتوانید از عامل بخواهید این گزارش را کوتاه بنویسد، اما نباید اجازه بدهید بخش «آزموده نشده» حذف شود تا نتیجه بهتر به نظر برسد. اگر اجرا ممکن نبوده، عبارت «تست پیشنهاد شد» با «تست اجرا و موفق شد» فرق دارد. همین تفکیک در بررسی انسانی و تحویل کار به همکار اهمیت دارد.
حریم خصوصی و انتخاب ابزار را جدا نگه دارید
برای گرفتن کمک لازم نیست لاگ خصوصی یا کد مشتری را بیبررسی ارسال کنید. نمونه کوچک و داده ساختگی اغلب برای توضیح مسئله آموزشی کافی است. اگر موضوع دسترسی به فایل و ابزار است، راهنمای حریم خصوصی Cursor مکمل این مطلب است؛ تمرکز این صفحه، صحت رفتار کد است، نه تنظیمات امنیتی حساب.
برای شناخت تفاوت نوع خرید، راهنمای اشتراک Cursor و مشخصات گزینههای فعلی محصول را بررسی کنید. این آموزش وابسته به وعده یک پلن خاص نیست و درباره موجودی یا امکانات همه گزینهها ادعایی نمیکند. خرید اشتراک جای مهارت آزمون و بازبینی را نمیگیرد و محدودیت دسترسی سرویس را هم برطرف نمیکند.
منابع و دامنه این آموزش
منابع رسمی در ۱۵ نوامبر ۲۰۲۶ بررسی شدند: Reviewing and Testing Code، Agent Review و Best practices for coding with agents از Cursor؛ و unittest، Built-in Functions و Built-in Types از مستندات Python. سه لینک اصلی در متن آمده است. قرارداد ارسال، جدول ورودیها و کد نمونه برای همین آموزش طراحی شدهاند؛ تعرفه واقعی، داده مشتری یا تجربه ادعایی از پروژه تجاری نیستند. نتیجه اصلی ساده است: نیاز را روشن کنید، انتظار را مستقل بنویسید و هر ادعای صحت را به آزمونی مشخص وصل کنید.
نویسنده و تحلیلگر ابزارهای هوش مصنوعی، با تمرکز بر بهرهوری و آموزش کاربردی برای مخاطب فارسیزبان.
مطالب پیشنهادی برای شما
دیدگاهها
نظرتان برای دیگران ارزشمند است